Zusammenfassung: Eine grössere NPU garantiert keine schnellere Edge AI. TOPS misst eine Stufe einer längeren Pipeline. Bevor Sie Hardware neu entwerfen, finden Sie heraus, wohin die Millisekunden tatsächlich gehen.
TOPS ist nicht gleich Edge-AI-Performance
Sie haben die NPU von 2 TOPS auf 10 TOPS aufgerüstet, und Ihre Edge AI ist immer noch langsam. Wie ist das möglich? Weil die NPU nur ein Teil der Pipeline ist:
Kamera → ISP → Vorverarbeitung → NPU → Nachverarbeitung → Anwendung
Was TOPS tatsächlich misst
TOPS (Tera-Operationen pro Sekunde) ist ein Spitzenwert: wie viele einfache Operationen der Beschleuniger unter idealen Bedingungen pro Sekunde ausführen kann, meist bei einer bestimmten numerischen Genauigkeit wie INT8. Er sagt nichts darüber aus, wie gut Ihr konkretes Modell auf den Beschleuniger passt, wie schnell die Daten ihn erreichen oder was vor und nach der Inferenz passiert.
Ein Modell erreicht den Spitzendurchsatz nur, wenn jede Schicht auf der NPU läuft, die Daten bereits im richtigen Format und Speicher liegen und nichts anderes um Bandbreite konkurriert. Reale Pipelines sehen selten so aus.
Wo sich der eigentliche Engpass versteckt
Die Zeit geht oft ausserhalb der NPU verloren. Der eigentliche Engpass kann sein:
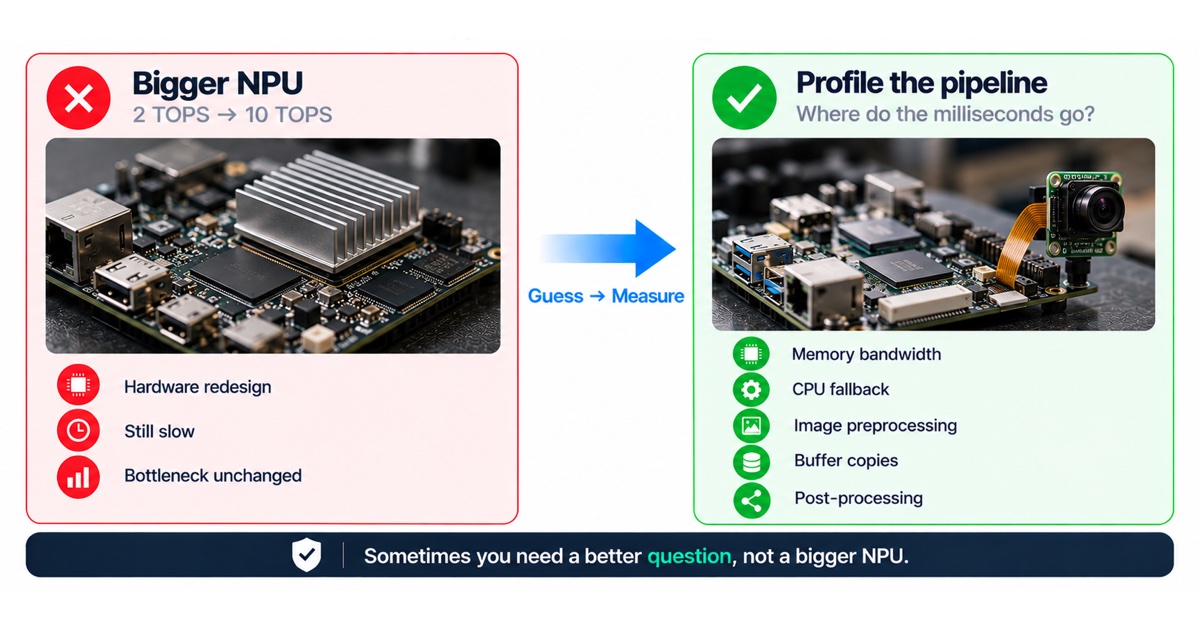
- Speicherbandbreite.
- CPU-Fallback.
- Bildvorverarbeitung.
- Pufferkopien.
- Nachverarbeitung.
Trotzdem lautet die erste Reaktion oft: «Wir brauchen eine grössere NPU.»

Wie sich jeder Engpass zeigt
| Engpass | Was passiert | Typische Lösung |
|---|---|---|
| Speicherbandbreite | Die NPU wartet auf Daten, besonders bei grossen Eingaben oder mehreren Modellen | Kleinere Eingabeauflösung, weniger Kopien, besseres Speicherlayout |
| CPU-Fallback | Schichten, die die NPU nicht unterstützt, laufen auf der CPU | Nicht unterstützte Operatoren ersetzen, Modell oder Konvertereinstellungen anpassen |
| Bildvorverarbeitung | Skalierung, Farbkonvertierung und Normalisierung laufen auf der CPU | In den ISP, einen Hardware-Scaler oder ins Modell verlagern |
| Pufferkopien | Bilder werden zwischen Kamera-, CPU- und NPU-Puffern kopiert | Zero-Copy-Puffer zwischen den Pipeline-Stufen |
| Nachverarbeitung | Dekodieren der Erkennungen und Filtern der Ergebnisse dauert länger als die Inferenz | Den Dekodierschritt optimieren oder verlagern, Kandidatenboxen reduzieren |
Stellen Sie eine bessere Frage
Hier unterscheiden sich Engineering-Ansätze. Manche Teams setzen die Anforderung einfach um. Manche hinterfragen die Technologie. Manche stellen eine wichtigere Frage: Wohin gehen die Millisekunden tatsächlich?
Diese Frage kann den Unterschied machen zwischen der Optimierung des Systems und dem Redesign von Hardware, die nie das Problem war. Manchmal brauchen Sie eine grössere NPU. Manchmal brauchen Sie eine bessere Frage.
So finden Sie heraus, wohin die Millisekunden gehen
- Die Latenz von der Bildaufnahme bis zum Anwendungsergebnis auf dem Zielgerät messen.
- Jede Stufe der Pipeline mit Zeitstempeln versehen: Aufnahme, ISP, Vorverarbeitung, Inferenz, Nachverarbeitung und Anwendungslogik.
- Mit den Profiling-Tools des Herstellers prüfen, welche Modellschichten auf der NPU laufen und welche auf die CPU zurückfallen.
- CPU-Last, Speicherbandbreite und Temperatur beobachten, während die Pipeline lange läuft, nicht nur bei einem kurzen Benchmark.
- Die gemessene Inferenzzeit mit dem Benchmark des Herstellers für dasselbe Modell und dieselbe Genauigkeit vergleichen.

Wann eine grössere NPU die richtige Antwort ist
Manchmal ist sie es. Wenn das Profiling zeigt, dass die Inferenz selbst dominiert, das Modell bereits vollständig auf dem Beschleuniger läuft, die Datenbewegung effizient ist und sich das Modell nicht verkleinern lässt, ohne die nötige Genauigkeit zu verlieren, ist mehr Beschleunigerkapazität eine vernünftige Entscheidung. Entscheidend ist, sie anhand von Messungen zu treffen, bevor die Hardware neu entworfen wird.
Checkliste vor einem SoC-Wechsel
- Haben wir ein Latenzbudget für die ganze Pipeline, aufgeteilt nach Stufen?
- Läuft jede Schicht des Modells auf der NPU?
- Werden Bilder öfter kopiert als nötig?
- Läuft die Vorverarbeitung auf der CPU, obwohl die Hardware sie übernehmen könnte?
- Haben wir unter Dauerlast und bei realer Temperatur getestet?
- Was ändert sich mit einem neuen SoC noch: BSP, Treiber, Energie, Wärmedesign und Zertifizierung?
Ein praktisches Latenzbudget
Beginnen Sie jedes Edge-AI-Projekt mit einem Latenzbudget für die ganze Pipeline, nicht nur für das Modell. Teilen Sie das Ziel in Stufen auf: Aufnahme und ISP, Vorverarbeitung, Inferenz, Nachverarbeitung und die eigene Logik der Anwendung, einschliesslich Netzwerk- oder Anzeigeschritten. Messen Sie dann jede Stufe so früh wie möglich auf der Zielhardware, auch mit einem Platzhaltermodell.
Das Budget macht aus einer vagen Beschwerde («es ist langsam») eine konkrete Frage («die Nachverarbeitung dauert länger als die Inferenz»). Es zeigt auch, wo Hardware zählt und wo Software die schnellere Lösung ist.
Hardwareentscheidungen, die mehr zählen als Spitzen-TOPS
- Welche Operatoren und Genauigkeiten der Beschleuniger unterstützt und wie ausgereift die Modellkonvertierungs-Tools des Herstellers sind.
- Die Speicherbandbreite und wie Kamera, ISP, CPU und Beschleuniger sie teilen.
- Hardwareblöcke für Skalierung und Farbkonvertierung, die die Vorverarbeitung von der CPU nehmen können.
- Unterstützung für das Teilen von Puffern zwischen Stufen ohne Kopien.
- Das Wärmeverhalten unter Dauerlast im realen Gehäuse.
Diese Faktoren bestimmen die reale Performance oft stärker als die TOPS-Angabe und sind es wert, vor der Plattformwahl geprüft zu werden.
FAQ
Warum sieht der Benchmark des Herstellers so viel besser aus?
Benchmarks messen meist nur die Inferenz, mit einem Modell, das zum Beschleuniger passt. Ihre Pipeline ergänzt Kamera, Vorverarbeitung, Kopien und Nachverarbeitung, und Ihr Modell kann Schichten enthalten, die auf die CPU zurückfallen.
Löst Quantisierung das Problem?
Quantisierung hilft oft bei Inferenzgeschwindigkeit und Speicherbedarf, behebt aber keine Kopien, keinen CPU-Fallback und keine langsame Nachverarbeitung. Sie braucht ausserdem eine Genauigkeitsprüfung mit realen Daten.
Wie lange dauert das Profiling?
Meist deutlich kürzer als ein Hardware-Redesign. Eine erste Aufschlüsselung, wohin die Zeit geht, reicht oft für die Entscheidung über den nächsten Schritt.
Kann dasselbe Modell auf derselben Hardware schneller laufen?
Oft ja. Das Modell mit den Tools des Herstellers in einer unterstützten Genauigkeit konvertieren, Operatoren ersetzen, die auf die CPU zurückfallen, die Eingabeauflösung reduzieren, wo die Genauigkeit es erlaubt, und Kopien zwischen Stufen entfernen: Jeder dieser Schritte kann ohne Hardwareänderung viel bewirken. Messen Sie jeden Schritt einzeln, damit Sie wissen, welche Änderung geholfen hat.
Was ist, wenn mehrere Modelle gleichzeitig laufen?
Mehrere Modelle konkurrieren um denselben Beschleuniger, dieselbe Speicherbandbreite und dieselbe CPU-Zeit. Planen Sie ihre Ausführung bewusst, teilen Sie die Vorverarbeitung, wo die Eingaben gleich sind, und messen Sie die kombinierte Pipeline unter Dauerlast. Ein zweites Modell kostet oft mehr, als sein Benchmark vermuten lässt.
Wie verhindern wir, dass die Performance nachlässt?
Nehmen Sie einen Latenztest der Pipeline in den Release-Prozess auf, ausgeführt auf der Zielhardware. Ein neues Modell, ein neuer Treiber oder ein Betriebssystem-Update kann die Performance verändern, und eine einfache automatische Prüfung erkennt das, bevor Geräte im Feld langsamer werden.
Wie wir helfen
Wir profilieren und optimieren Edge-AI-Pipelines auf dem Zielgerät und prüfen die SoC-Auswahl, bevor sie festgelegt ist. Siehe unsere Leistungen Edge AI und Computer Vision und Review der SoC- und SoM-Auswahl. Wenn Ihr Modell auf dem Gerät langsamer ist, als der Benchmark versprochen hat, sprechen Sie mit einem Ingenieur.