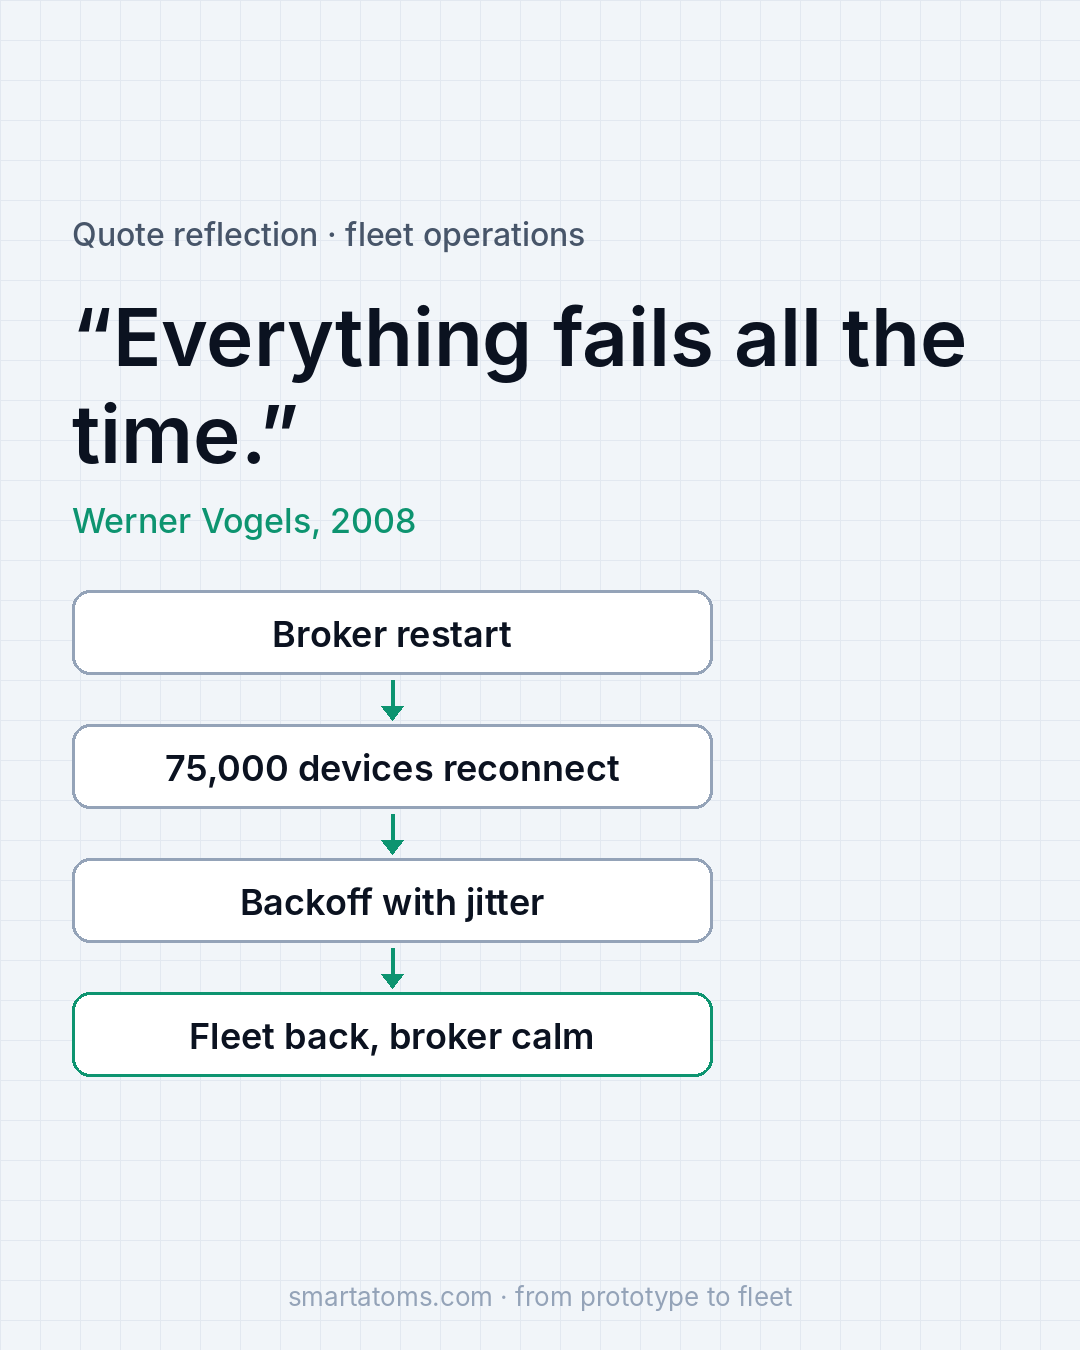
Zusammenfassung: «Everything fails all the time» – alles fällt ständig aus. So beschreibt Werner Vogels, CTO von Amazon, den Betrieb großer Systeme seit mindestens 2008. Für eine Flotte vernetzter Geräte hat der Satz eine sehr konkrete Bedeutung: Die Cloud wird ab und zu weg sein, und wenn sie zurückkommt, kommen alle Geräte gleichzeitig zurück. Die LaMetric-Cloud bedient rund 75.000 Geräte online bei 99,9 % Verfügbarkeit. Dieser Beitrag handelt von dem Teil, den diese Zahl nicht zeigt: was die Flotte in den Stunden Ausfallzeit tut, die 99,9 % noch erlauben, und in der Minute danach. Es geht um Broker-Neustarts, Reconnect-Stürme, Backoff mit Jitter, Geräte, die offline weiterarbeiten, Alarme, die die Flotte beobachten statt nur die Server, und darum, was uns die frühe LaMetric-Flotte über Retained Messages in MQTT gelehrt hat.
Was 99,9 % Verfügbarkeit noch erlauben
99,9 % klingt fast perfekt. Über ein Jahr erlaubt das trotzdem fast 9 Stunden Ausfallzeit. Ein Teil davon ist geplant: ein Broker-Upgrade, ein Kernel-Patch, eine Datenbankmigration. Ein Teil nicht. So oder so wird es passieren, und zwar während die Geräte in Wohnungen und in Werkshallen eingeschaltet sind.
Die nützliche Frage lautet also nicht «Wie fallen wir nie aus?», sondern «Was tut die Flotte, während wir weg sind, und was tut sie in dem Moment, in dem wir zurück sind?» Ein Backend, das sich schnell erholt, kann trotzdem viel länger Ärger machen, wenn sich die Geräte bei seiner Rückkehr schlecht verhalten. Die Verfügbarkeit misst den Dienst. Was die Menschen an den Geräten erleben, hängt von der Flotte ab.
Der Broker-Neustart aus Sicht des Geräts
Die meisten vernetzten Geräte halten eine langlebige MQTT-Verbindung zur Cloud. Darüber senden sie Messwerte, empfangen Befehle und erfahren von Updates. Startet der Broker neu, reißen all diese Verbindungen im selben Moment ab. Ob der Neustart geplant war oder ein Absturz, spielt keine Rolle: Für das Gerät sieht beides gleich aus.
Was danach passiert, entscheidet Firmware, die Monate oder Jahre vorher geschrieben wurde. Versucht sie einfach so schnell wie möglich neu zu verbinden, ist die Rückkehr des Brokers der Beginn des nächsten Problems, nicht das Ende des ersten.
Reconnect-Stürme: die eigene Flotte als Angreifer
Stellen Sie sich 75.000 Geräte vor, die alle in derselben Sekunde ihre Verbindung verloren haben. Wartet jedes ein festes Intervall und versucht es dann erneut, versuchen es auch alle in derselben Sekunde erneut. Für den Broker, der gerade wieder hochfährt, mit kalten Caches und allen Sitzungen neu aufzubauen, sieht diese Welle genau wie ein Angriff auf die eigene Infrastruktur aus.
Der Broker wird langsam oder lehnt Verbindungen ab. Die Geräte laufen in Timeouts und versuchen es erneut. Ihre Versuche liegen wieder übereinander, und die nächste Welle ist so groß wie die erste. Aus einem kurzen Neustart wird ein langer Ausfall, den die Flotte selbst am Leben hält. In der Cloud ist nichts mehr kaputt; die Geräte kommen einfach alle gleichzeitig an.
Backoff mit Jitter, in der Firmware
Die Lösung sitzt im Gerät, nicht in der Cloud. Jedes Gerät wartet nach jedem fehlgeschlagenen Versuch länger (exponentielles Backoff) und addiert zu jeder Wartezeit einen zufälligen Versatz (Jitter). Das Backoff verhindert, dass ein Gerät einen Broker bestürmt, der noch nicht bereit ist. Der Jitter bricht die Welle auf, sodass sich die Versuche über Minuten statt Millisekunden verteilen und der Broker einen gleichmäßigen Strom sieht, den er verarbeiten kann, statt einer einzigen Spitze.
Das sind wenige Zeilen Code, und sie schützen jeden Ausfall und jeden geplanten Neustart, den die Flotte je erleben wird. Sie müssen aber in der Firmware sein, bevor man sie braucht. Fehlen sie Ihren Geräten heute, ist der Weg dorthin ein Over-the-Air-Update. Das ist ein weiterer Grund, warum ein zuverlässiger Update-Weg an erster Stelle steht: Das Wiederverbindungsverhalten einer Flotte, die Sie nicht erreichen, können Sie nicht korrigieren.
Geräte, die offline weiterarbeiten
Ein Gerät, das seine Verbindung verliert, sollte nicht seinen Zweck verlieren. Das Ziel ist einfach: die letzten gültigen Daten anzeigen und im Hintergrund leise neu verbinden. Eine Uhr zeigt weiter die Zeit. Ein Display zeigt weiter die zuletzt empfangenen Werte. Die Person davor sollte im besten Fall gar nicht merken, dass die Cloud weg war.
Das verlangt bewusste Entscheidungen in der Firmware: was lokal zwischengespeichert wird, wie alt Daten sein dürfen, bevor das Gerät sie als veraltet markiert, und welche Funktionen die Cloud wirklich brauchen und das ehrlich anzeigen sollten. Ein leerer Bildschirm oder eine Fehlermeldung während eines kurzen Broker-Neustarts macht aus einem Backend-Ereignis ein Support-Ticket.
Alarme auf die Flotte, nicht nur auf die Server
Server-Metriken sagen, ob die Maschinen gesund sind. Sie sagen nicht, ob es die Geräte sind. Ein Broker kann bei niedriger CPU-Last laufen, während die halbe Flotte keine Verbindung bekommt. Deshalb alarmieren wir zusätzlich auf zwei Signale der Flotte: die Zahl der verbundenen Geräte und die Nachrichtenrate.
Während eines Neustarts sollte die Zahl der verbundenen Geräte fallen und dann wieder auf den alten Stand steigen. Steigt sie nur langsam oder bleibt auf halbem Weg stehen, stimmt etwas im Wiederverbindungsweg nicht. Kommt die Nachrichtenrate nicht mit zurück, sind Geräte zwar verbunden, arbeiten aber nicht. Beides ist auf einem Flotten-Dashboard innerhalb von Minuten sichtbar, lange bevor jemand ein Ticket aufmacht.
Hier dasselbe Bild als Tabelle: was ausfällt, was die Flotte tut und wofür wir entwickeln.
| Ereignis | Was die Flotte tut | Wofür wir entwickeln |
|---|---|---|
| Broker-Neustart | Jedes Gerät verliert im selben Moment seine MQTT-Verbindung | Geräte, die damit rechnen und weiterarbeiten |
| Broker ist zurück | Die ganze Flotte versucht gleichzeitig neu zu verbinden | Backoff mit Jitter, damit sich die Versuche über Minuten verteilen |
| Cloud nicht erreichbar | Keine neuen Daten erreichen das Gerät | Letzte gültige Daten zeigen und leise neu verbinden |
| Teilweise Erholung | Server wirken gesund, ein Teil der Flotte bleibt offline | Alarme auf verbundene Geräte und Nachrichtenrate, nicht nur auf CPU |
Was wir auf die harte Tour gelernt haben
Wir haben das in den Anfangstagen von LaMetric auf die harte Tour gelernt. Als die Flotte wuchs, fielen einige Cloud-Dienste unter Last aus. Retained Messages in MQTT verbrauchten mehr Broker-Ressourcen als erwartet, und die wachsende Zahl an Geräteverbindungen verschärfte das Problem.
Die Lösung war nicht einfach ein größerer VPS. Wir haben unnötige Retained Topics reduziert, das Protokoll optimiert und die Infrastruktur so skaliert, dass sie die wachsende Flotte trägt.
Die Lehre: Ein Design, das für Hunderte Geräte funktioniert, kann bei Tausenden zum Infrastrukturproblem werden. Retained Messages, Verbindungszahlen und Wiederverbindungsverhalten wirken bei einer kleinen Flotte harmlos. Ihre Kosten zeigen sich erst, wenn die Flotte wächst, deshalb lohnt es sich, sie vorher zu prüfen.
Die Wiederherstellung testen, nicht nur den Dienst
Die Regel, die wir von Vogels mitnehmen: Testen Sie die Wiederherstellung, nicht nur den Dienst. Die meisten Teams testen, ob das Backend funktioniert. Weniger testen, was passiert, wenn es mit einer echten Flotte dahinter stoppt und wieder startet.
Starten Sie also einen Broker bewusst neu, bevor die Produktion es für Sie tut. Wählen Sie eine ruhige Stunde, informieren Sie das Team und beobachten Sie die Dashboards: wie schnell die Zahl der verbundenen Geräte fällt, wie schnell sie zurückkommt, ob sie den alten Stand erreicht und ob die Nachrichtenrate folgt. Kämpft der Broker, wenn die Flotte zurückkommt, haben Sie Ihren Reconnect-Sturm zu Ihren eigenen Bedingungen gefunden, mit Leuten, die zuschauen, und einem Plan in der Hand, statt nachts ohne beides.
Funktioniert es, machen Sie es weiter. Firmware ändert sich, Flotten wachsen, Broker werden aktualisiert. Eine Wiederherstellung, die Sie letztes Jahr getestet haben, ist eine, von der Sie hoffen, dass sie noch funktioniert.

Eine kurze Checkliste für Ihre Flotte
- Verbinden sich Ihre Geräte mit exponentiellem Backoff und zufälligem Jitter neu, oder in einem festen Intervall?
- Können Sie dieses Verhalten per Over-the-Air-Update ergänzen oder ändern, falls es fehlt?
- Was zeigt jedes Gerät, wenn die Cloud nicht erreichbar ist: die letzten gültigen Daten oder einen Fehler?
- Alarmieren Sie auf verbundene Geräte und Nachrichtenrate oder nur auf CPU und Speicher der Server?
- Welche Retained Topics brauchen Ihre Geräte wirklich, und was kosten sie den Broker, wenn die Flotte wächst?
- Wann haben Sie Ihren Broker zuletzt bewusst neu gestartet, und was hat die Flotte getan?
Lautet die letzte Antwort «nie», ist das der erste Test, den Sie planen sollten.
Wie wir helfen
Bei Smart Atoms betreiben und überwachen wir Cloud-Plattformen für Geräteflotten und schreiben die Firmware, die mit ihnen spricht, vom ersten Prototyp bis zur Flotte, die online bleibt. Dazu gehören MQTT-Broker, Wiederverbindungsverhalten, Flotten-Dashboards und Over-the-Air-Updates, alles bewährt auf der LaMetric-Plattform. Sehen Sie, wie wir SRE und 24/7-Plattformbetrieb angehen. Wenn Sie prüfen möchten, wie sich Ihre Flotte verhält, wenn die Cloud weg ist, sprechen Sie mit einem Ingenieur.
Quelle: Smart Atoms, aus dem Betrieb der LaMetric-IoT-Plattform (rund 75.000 Geräte online). Zitat: Werner Vogels, «Everything Fails All the Time», Communications of the ACM, 2020.